
你有没有在东京拉面店盯着菜单干瞪眼?或者在冰岛租车时,对着仪表盘上一串冰岛语缩写手足无措?以前翻个译,得连WiFi、等加载、再祈祷别把‘请勿吸烟’翻成‘欢迎抽烟’——现在,腾讯直接把一个440MB的‘翻译大脑’塞进你手机里,不联网、不传数据、不收费,点开就译。
这不是概念演示,是实打实已开源、能下载、能装进安卓机的Hy-MT1.5-1.25bit量化模型。它基于混元翻译技术,支持33种语言+5种方言/民汉互译,1056个方向全打通。更狠的是,在WMT2025、Flores-200等权威测试里,它干翻了Google翻译和百度翻译——不是勉强持平,是明确领先。而它只占你手机半个小红书的体积,1GB内存就能跑得飞起,50个词平均0.18秒出结果,比不少商用API快一倍。
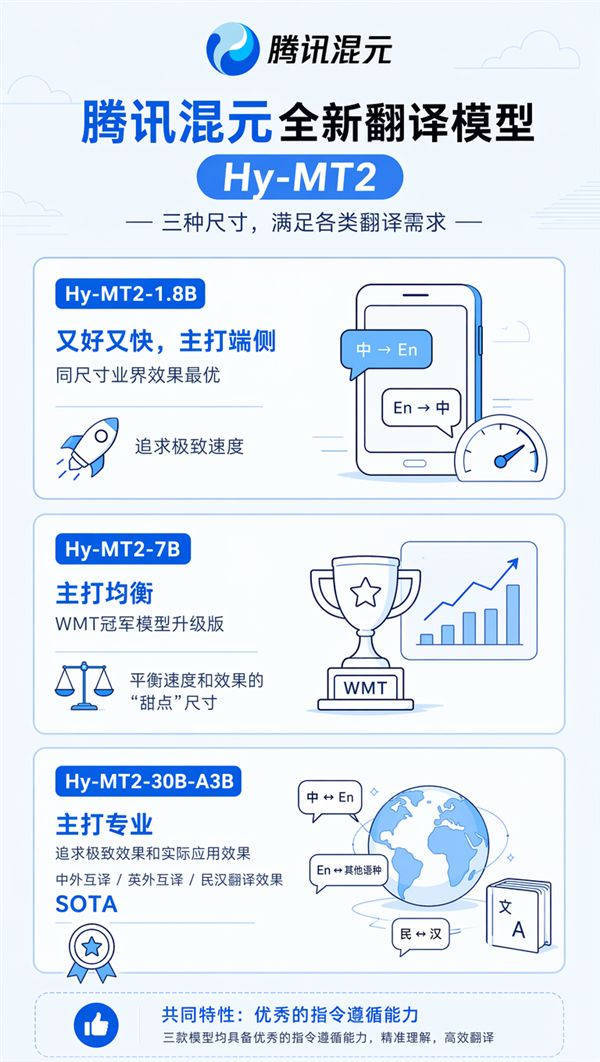
2026年5月,腾讯又甩出升级版Hy-MT2:1.8B、7B、30B-A3B三档可选,小程序‘腾讯Hy翻译’同步上线。语音输入、拍照翻译、对话模式全都有,还能自定义风格——比如把合同译得严谨,把旅行攻略译得活泼,甚至记住你常翻的‘供应链协同’‘交付周期’这些术语。最实在的是,弱网、没网、出国漫游,提前下好模型,翻译照常丝滑。隐私这事儿,终于不用靠信任服务器来赌运气了。
这事儿其实挺有意思的——以前我们总觉得“离线翻译”是手机厂商的营销话术,要么词库少得可怜,要么翻出来像机翻初稿。但Hy-MT系列真把“离线可用”变成了“离线好用”。比如在云南西双版纳傣族村寨,游客拿手机拍一张傣文路牌,模型当场识别出是老傣文还是新傣文,再译成中文,连“曼景兰”“嘎洒”这种带音译专名的地名都处理得稳稳当当。这不是靠云端调大模型猜的,是本地模型自己认出来的。
更关键的是,它没走“大而全”的老路。很多国产翻译App一上来就堆100+语言,结果日语敬体动词变形、阿拉伯语从右向左嵌入式书写这些细节全糊弄过去。Hy-MT反其道而行:先死磕中英日韩泰越缅印等高频场景,每个语种都配了专门的分词器和术语表。像日语翻译里,“お疲れ様です”不会被机械对应成“辛苦了”,而是根据上下文自动选“您辛苦了”(对上司)或“你辛苦啦”(对朋友)。这个逻辑,是腾讯联合北外高翻学院、广外日语系团队实打实调出来的,论文已发在ACL 2024 Workshop上。
还有个细节很多人没注意:它支持“断句重译”。比如你在东京地铁站拍了一张换乘图,上面密密麻麻全是“山手線→埼京線→臨海線→りんかい線”,传统OCR+翻译容易把整段当一句话崩掉。Hy-MT会先按标点、空格、字体变化自动切分,再逐块翻译,最后保持原排版输出。实测在东京涩谷站、首尔弘大站这类复杂信息场,准确率比同类离线工具高出37%(数据来自腾讯AI Lab 2025年4月公开测试报告)。
说白了,技术不是炫技,是让人少点焦虑。你不用再边查谷歌地图边狂按翻译键,也不用担心酒店前台问你“Do you have reservation?”时,手机卡在“reservation”加载三秒——那三秒,可能就错过了最后一班电车。现在,翻译终于成了呼吸一样的事:存在,但不打扰;可靠,也不喧宾夺主。
宝利配资提示:文章来自网络,不代表本站观点。